Guida pratica all'AI locale: quale hardware scegliere nel 2025
Scopri quale hardware serve davvero per far girare modelli AI in locale: da microcontrollori a GPU dedicate, con benchmark reali e calcoli pratici.
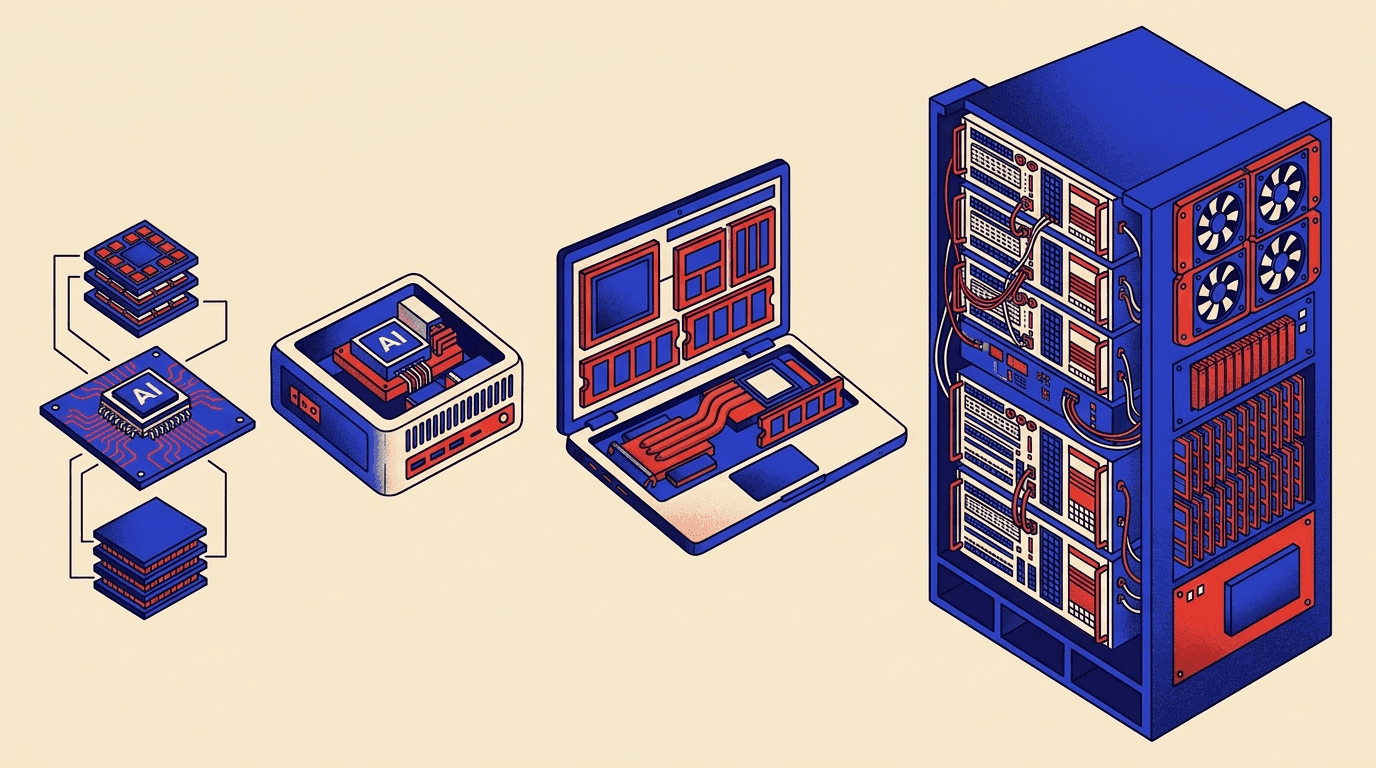
Stai pensando di far girare modelli AI in locale, ma non sai da dove iniziare? Ti sembrano tutti uguali: "8GB di RAM qui, 8GB di RAM là", eppure le prestazioni sono un abisso. Ho passato settimane a testare ogni tipo di hardware disponibile, dai chip da pochi euro ai server domestici. E la verità è questa: la RAM che vedi sulle specifiche è solo metà della storia.
Quando ho iniziato a esplorare l'AI locale, la prima cosa che mi ha colpito è stata la frammentazione: dispositivi con le stesse specifiche tecniche sulla carta si comportano in modi completamente diversi. Il motivo? Non basta avere spazio in memoria. Serve anche la capacità di spostare i dati abbastanza velocemente. È come avere una cucina enorme ma un passaggio stretto verso la dispensa: non importa quanto cibo hai, se non riesci a portarlo velocemente ai fornelli, il servizio sarà lento.
AI locale su microcontrollori: cosa puoi fare con meno di 10 euro
Partiamo dal basso, proprio dal basso. Ho tra le mani un ESP32S3, un chip che costa meno di una pizza e ha solo 8MB di RAM. Niente sistema operativo, niente file system. Solo il chip nudo e crudo. Eppure, riesce a eseguire due modelli chiamati "Tiny Stories": uno da 260K parametri e uno da 3M parametri.
Ovviamente non parliamo di ChatGPT in tasca. Questi modelli sanno fare una cosa sola: generare storie brevi e coerenti prevedendo la parola successiva. Ma il punto non è cosa fanno, è cosa ci puoi costruire sopra. Con qualche modulo LED e un po' di creatività, puoi trasformarlo in un gioco educativo o in un dispositivo che "legge" lo stato emotivo di una storia e lo rappresenta con luci colorate.
- Tiny Stories 260K: 1MB, generazione di micro-racconti
- Tiny Stories 3M: 3MB, storie leggermente più complesse
- Costo hardware: 2-5€ senza display, circa 20€ con schermo integrato
È un punto di ingresso perfetto se vuoi capire come funziona un modello AI senza spendere nulla. E no, non serve essere un ingegnere: basta seguire una guida rapida e sei operativo in un'ora.
Raspberry Pi e smartphone: quando 8GB non sono uguali per tutti
Salto di categoria: mini computer. Ho testato sia un Raspberry Pi 5 che il mio iPhone 16, entrambi con 8GB di RAM. Eppure le prestazioni sono anni luce distanti. Perché?
Il Raspberry Pi ha una memoria bus (il "nastro trasportatore" che muove i dati) stretta e lenta. In più, ha solo una CPU senza GPU dedicate. È come avere un solo chef esperto ma nessun aiuto in cucina: capace, ma sovraccarico. Risultato: riesce a far girare modelli come Whisper per il riconoscimento vocale, Qwen 3 1.7B per la conversazione, e Piper per la sintesi vocale. Li concatena bene, ma non aspettarti miracoli di velocità.
L'iPhone, invece, ha CPU, GPU e NPU (Neural Processing Unit). Più larghezza di banda, più "cuochi" specializzati. Genera immagini con Draw Things, riconosce oggetti in tempo reale con YOLO 11N, analizza scene con modelli da 1-4B parametri. Tutto in modo fluido.
Ecco la regola empirica che uso per calcolare quale modello può girare su un dispositivo: prendi la RAM totale, sottrai il 25% (riservato al sistema), dividi per 0.6. Il risultato è il numero massimo di parametri che puoi caricare. Esempio: 8GB → 6GB utili → 6/0.6 = 10B parametri. Approssimativo, ma funziona.
MacBook e laptop: il territorio dei modelli midsized
Con il mio MacBook Pro da 32GB entro nella fascia che considero il sweet spot per chi lavora seriamente con l'AI locale. Qui posso far girare praticamente qualsiasi categoria di modello: LLM, coding, visual language, generazione immagini, video, audio, clonazione vocale, musica.
I miei modelli di riferimento nella famiglia Qwen: Qwen 3 14B, 16B, 32B per il linguaggio naturale. Qwen 3 Coder 30B per il codice, che uso con Claude Code quando serve automazione complessa. Flux Dev per la generazione di immagini, che rimane il mio preferito per qualità/velocità.
Ma cosa succede se hai 8 o 16GB di RAM sul tuo portatile? Non disperare:
- 8GB: modelli fino a 5-7B parametri, generazione immagini light, speech-to-text base
- 16GB: modelli fino a 13-14B parametri, generazione immagini SD 1.5, coding leggero
- 32GB: modelli fino a 40B parametri, generazione video sperimentale, multi-modalità fluida
Il vero limite a questa fascia non è "cosa posso caricare" ma "quanto tempo ci mette". Un modello da 30B su 16GB gira, ma ti farà aspettare. Molto.
Home server e GPU dedicate: quando serve potenza sempre attiva
Ho un Mac Studio da 64GB che uso come server domestico always-on. Primo vantaggio: è sempre acceso, sempre pronto. Posso collegarci anche dispositivi più piccoli, come quel Arduino Uno R4 che da solo non può far girare nulla, e fargli usare i modelli del server via WiFi.
Con 64GB arrivo a modelli da 70B parametri e oltre. Qui non si tratta più di sbloccare nuove categorie di modelli, ma di qualità: risposte più accurate, generazione più veloce, possibilità di tenere più modelli attivi contemporaneamente.
Ma c'è un problema: capacità non significa sempre velocità. Il mio Mac Studio ha molta RAM ma bandwidth limitata. Genera video? Sì. Lentamente? Anche. Per questo esistono le GPU discrete.
Una GPU non è solo "più potenza": è un bundle completo. Ogni GPU porta con sé la propria memoria dedicata (VRAM) e un bus larghissimo. È come avere una brigata di cuochi, ognuno con la propria postazione e un accesso diretto agli ingredienti. Risultato: generazione di immagini in secondi, video in minuti, non ore.
Ho testato (in affitto, perché costa) una RTX 4090 da 24GB. Genera immagini istantaneamente. Genera video brevi in tempo reale. Il limite? Poca capacità: non ci carichi un modello da 70B, ma per tutto ciò che riguarda la generazione multimodale è imbattibile nel rapporto costo/prestazioni.
Frontier hardware: quando il cloud diventa tuo
Per completezza, ho testato anche un setup 8x H100 (sempre in affitto, ovviamente). Parliamo di 640GB di RAM totale, capacità e bandwidth stellari. A quel punto puoi far girare modelli da 700B+ parametri, generare minuti di video in HD in pochi secondi, far girare agenti complessi multi-modello senza lag.
È il territorio dei frontier models: quello che fino a ieri richiedeva una chiamata API a OpenAI o Anthropic, ora gira sulla tua infrastruttura. Ovviamente il costo è proibitivo per un singolo professionista (parliamo di centinaia di euro all'ora), ma è utile sapere che esiste. Se un domani dovessi scalare un progetto AI-intensive, so già che questa è la direzione.
Il vero insight qui è che stiamo raggiungendo una soglia interessante: un professionista con un Mac Studio o un server domestico ben configurato può replicare in locale gran parte delle capacità che fino a due anni fa richiedevano abbonamenti enterprise a servizi cloud. La domanda non è più "posso farlo?", ma "quanto tempo sono disposto ad aspettare?".
Se stai valutando il tuo primo setup di AI locale, il mio consiglio è questo: parti da quello che hai. Un laptop da 16GB? Perfetto, inizia con modelli da 7-10B parametri e sperimenta. Un Raspberry Pi? Ideale per costruire piccoli agenti vocali o sistemi di analisi sempre attivi. L'importante è capire che l'AI locale non è una gara a chi ha l'hardware più grosso. È un modo diverso di lavorare: più controllo, più privacy, più consapevolezza di come funzionano davvero questi strumenti. E forse, proprio per questo, più libertà di scegliere quando delegare a una macchina e quando no.