Come costruire una knowledge base personale con AI (guida pratica)
Scopri come costruire una knowledge base personale con AI: architettura pratica, connettori automatici, ricerca plain text e recency weighting per risposte sempre aggiornate.
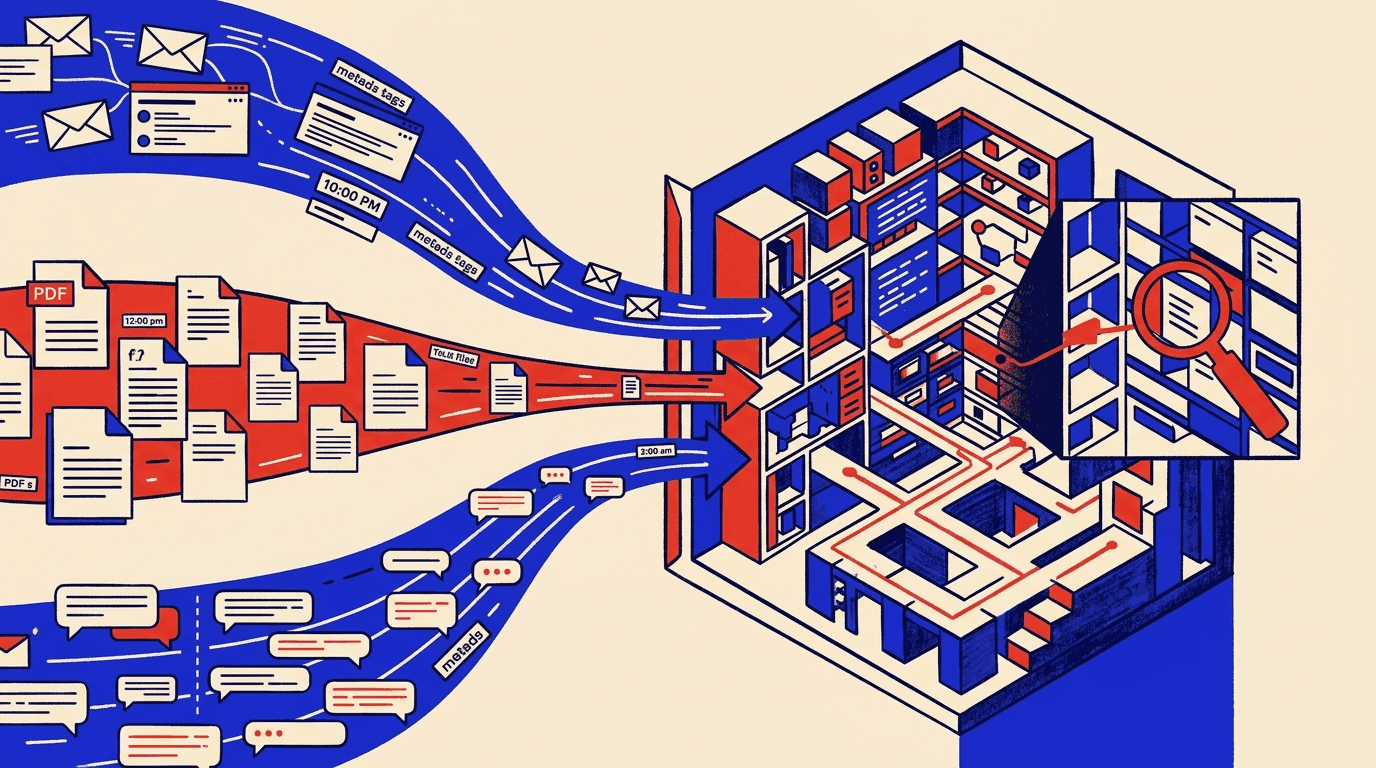
L'AI non ti ruberà il lavoro. Ma qualcuno con una memoria perfetta di tutto quello che ha fatto, detto e scritto negli ultimi mesi, sì. E quella memoria perfetta oggi si può costruire.
Quando ho iniziato a sperimentare con le knowledge base personali, pensavo fosse solo l'ennesima buzzword da marketer. Invece ho scoperto che dietro c'è un'idea concreta: trasformare tutto quello che produci ogni giorno (email, trascrizioni, sessioni con Claude, note sparse) in un sistema interrogabile che risponde sempre con le informazioni giuste. In questo articolo ti mostro come costruirne una funzionante, senza farti perdere in tecnicismi inutili.
Perché le knowledge base personali hanno senso (anche senza essere un'azienda)
Una knowledge base personale è, in sostanza, un archivio ricercabile dei tuoi contenuti più un'AI che consulta quell'archivio prima di risponderti. Gli ingegneri chiamano questo processo retrieval : quando lo combini con la generazione AI, diventa Retrieval Augmented Generation (RAG).
Qualche anno fa il RAG era indispensabile perché i modelli AI avevano finestre di contesto ridotte: non potevi inserire più di qualche pagina per volta. Oggi modelli come Claude gestiscono finestre enormi, equivalenti a 35-50 libri. In teoria potresti caricare tutto lì dentro. Ma ci sono tre problemi:
- Costa un sacco: elaborare milioni di token a ogni query non è sostenibile per un freelancer
- Prende tempo: l'AI deve scorrere montagne di testo per ogni risposta
- L'AI tratta tutto come ugualmente importante: il prezzo di un servizio che offrivi due anni fa ha lo stesso peso di quello attuale
Risultato? Risposte meno precise, costi alti, inefficienza. Una knowledge base ben costruita risolve questi problemi: l'AI cerca solo quello che serve, privilegia le informazioni recenti e risponde in tempi rapidi.
Come funziona una knowledge base AI efficace (architettura semplificata)
La struttura che uso io si basa su tre meccanismi:
Recency weighting : ogni informazione che entra nella knowledge base riceve un timestamp. Le informazioni più recenti ottengono un "boost" nella ricerca, quelle vecchie perdono rilevanza. Così l'AI sa che deve privilegiare i dati freschi.
Retrieval invece di dump : invece di caricare tutto nella finestra di contesto, memorizzo i dati altrove. Quando faccio una domanda a Claude, il sistema cerca rapidamente le informazioni pertinenti (di solito in meno di mezzo secondo) e aggiunge solo quelle alla query. Questo evita il context rot , il fenomeno per cui le performance dell'AI calano quando il contesto diventa troppo grande.
Plain text search con BM25 : niente vector database complessi o embeddings costosi. Uso un algoritmo di ricerca testuale semplice, in circolazione dagli anni '90, che assegna un punteggio ai documenti in base alla frequenza delle parole cercate. Funziona alla grande, costa pochissimo e l'inferenza è velocissima.
Risultato pratico? Non devo più preoccuparmi di dove ho salvato un'informazione, Claude non mi restituisce dati obsoleti e le risposte sono sempre contestualizzate rispetto al mio lavoro recente.
Step 1: definire le fonti e costruire i connettori
Una knowledge base vale quanto i dati che contiene. Il primo passo è identificare le tue fonti primarie:
- Email (Gmail, Outlook...)
- Sessioni con Claude o ChatGPT
- Trascrizioni di call o meeting
- Messaggi su Slack o altri tool di comunicazione
- Documenti di lavoro, proposte, contratti
Poi costruisci dei connettori : piccoli script che prelevano solo i dati nuovi dall'ultima esecuzione, li marcano con data e ora e li aggiungono alla base.
Esempio concreto: il mio connettore Gmail usa l'API in modalità read-only (fondamentale: non dare mai permessi di scrittura a questi script). Al primo avvio ha scaricato un anno di email. Da lì in poi preleva solo le nuove, ogni 15 minuti. Semplice, automatico, sicuro.
Un consiglio: aggiungi anche le sessioni con Claude. Sono già salvate in locale come plain text, ma normalmente vengono cancellate dopo 30 giorni. Indicizzarle ti permette di consultare conversazioni di mesi fa, fondamentali per recuperare decisioni, idee, dettagli di progetti passati.
Step 2: trasformare i dati in metadati ricercabili
Non puoi semplicemente buttare testo grezzo nella knowledge base. L'AI fatica a cercare in blocchi di testo non strutturati. La soluzione è creare metadati intelligenti per ogni elemento:
- Summary : un riassunto breve del contenuto, inclusa la domanda che probabilmente qualcuno farebbe per trovarlo
- Atoms : dettagli precisi come comandi, messaggi d'errore, cifre esatte, decisioni chiave
- Timestamp : data e ora di creazione o aggiornamento
Questi metadati trasformano informazioni implicite in memoria istituzionale esplicita. Ogni workflow, ogni scelta progettuale, ogni soluzione a un problema diventa consultabile.
Per generare i metadati uso Claude Haiku (versione economica): gli passo il contenuto grezzo con un prompt che descrive come strutturare summary e atoms. Il modello cerca poi nei metadati, non nel testo originale. Quando trova un match, punta al documento completo. Veloce, economico, preciso.
Step 3: implementare la ricerca e mantenere il sistema aggiornato
Come dicevo, la ricerca plain text con BM25 batte approcci più complessi per efficienza e costi. Niente vector database, niente embeddings: solo stringhe di testo enormi con un algoritmo che assegna score in base alla frequenza delle keyword.
Dopo aver testato varie soluzioni RAG, ho scoperto che questo approccio minimale riduce i tempi di inferenza del 90% e abbatte i costi di gestione. Claude riesce a inferire il resto del contesto in modo intelligente, senza bisogno di architetture sofisticate.
Una volta attivo, il sistema deve rimanere fresco. Serve uno script di controllo in background che:
- Verifica che i connettori funzionino (API key valide, permessi attivi, route accessibili)
- Rimuove periodicamente dati obsoleti o irrilevanti
- Aggiorna i timestamp e ricalcola i pesi di recency
Le API cambiano, le chiavi scadono, i servizi si aggiornano. Un sistema trascurato diventa inutile nel giro di poche settimane.
Cosa cambia davvero con una knowledge base funzionante
Uso questo sistema da mesi. Il vantaggio concreto non è avere "un secondo cervello" (che suona bellissimo ma dice poco). È non dover più ricordare dove ho messo un'informazione. È avere Claude che risponde sempre con i dati giusti, aggiornati, pertinenti al contesto attuale del mio lavoro.
Esempio pratico: sto preparando una proposta per un cliente. Chiedo a Claude: "Quali erano i termini dell'ultimo progetto simile?" Il sistema cerca nelle mie email, nelle sessioni passate, nei documenti salvati, trova il progetto più recente con caratteristiche analoghe e mi restituisce prezzi, tempistiche, note operative. Tutto in pochi secondi.
Oppure: sto debuggando un workflow di automazione in Make. "Quale errore avevo risolto l'ultima volta con l'integrazione Stripe?" Claude consulta i log, le conversazioni passate, i documenti tecnici e mi risponde con il fix esatto, il comando usato, la motivazione della scelta.
Non è magia. È solo informazione organizzata, accessibile al momento giusto.
Se stai iniziando a sperimentare con l'AI nel tuo lavoro, il mio consiglio è questo: parti dalle tue fonti più critiche (email e sessioni con l'AI, probabilmente) e costruisci un connettore semplice. Usa un modello economico per generare i metadati. Testa la ricerca plain text con BM25. Vedrai subito se il sistema ha senso per te. E forse ti accorgerai, come è successo a me, che la vera produttività non sta nell'usare l'AI più potente, ma nel darle accesso alla tua memoria.